Cortex 记忆系统
Cortex 将所有知识以原子化、带索引的 markdown 文件存储在文件系统中——即 Dense Context 结构。没有向量数据库、没有 RAG 管道、没有外部知识存储。文件系统就是数据库。关于这如何融入更广泛的系统架构,参见 architecture.md。
为什么使用原子化记忆
核心洞察是单体上下文文件无法扩展。单个 EXPERIMENTS.md 文件无限增长,使其加载到智能体上下文时代价高昂且难以搜索。解决方案是将每个实验、知识条目和模式原子化为自己的文件,并带有自动生成的索引以便快速查找。
此设计借鉴了学术工作:Du 2026 的智能体内存模式调查,QMatSuite 的分层知识层次(finding → pattern → principle),以及 A-MEM 的带动态链接的原子笔记(100 万条记忆时检索时间 < 4μs)。
目录布局
知识根目录是 ~/.cortex/context/,结构如下:
context/
├── AGENTS.md                    # 根索引——查找任何内容的入口点
├── OVERVIEW.md                  # 全局概览:每项目一行状态 + 上次扫描日期
├── decisions/                   # 系统级设计决策(NNNN-title.md)
├── ideas/                       # 孵化中的研究方向
├── scans/                       # 知识扫描报告,每天一份
├── user/                        # 用户偏好(由 /user-learn 维护)
│   └── USER.md                  # 语言、风格、工作习惯(< 3KB)
└── projects/                    # 每个活跃研究项目一个子目录
    └── <project>/
        ├── AGENTS.md            # 项目级索引
        ├── mission.md           # 目标和成功条件
        ├── roadmap.md           # 带可测试清单条件的里程碑
        ├── STATUS.md            # 现在时状态寄存器(覆盖式,最多 80 行 / 6KB)
        ├── ISSUES.md            # 执行摩擦(仅追加,已解决项删除,最多 80 行 / 6KB)
        ├── boards/              # 每个看板一个目录:board.html、assets/、decisions.jsonl
        ├── experiments/
        │   ├── index.md         # 自动生成——请勿手动编辑
        │   └── EXP-NNN.md       # 每实验一个文件,YAML frontmatter
        ├── knowledge/
        │   ├── index.md         # 自动生成
        │   └── K-NNN.md         # 每知识条目一个文件
        ├── patterns/
        │   ├── index.md         # 自动生成
        │   └── PAT-NNN.md       # 每跨实验模式一个文件
        ├── decisions/           # 项目级设计决策
        └── _meta/
            └── access-log.jsonl # 自动追踪的 Read/Grep 访问日志
cortex init 只创建根目录的 AGENTS.md,以及 ideas/、scans/、user/ 和 projects/ 的索引。
其余文件和目录在 Cortex 创建它们时出现:OVERVIEW.md 和 decisions/ 在有内容要记录时创建,
USER.md 由 user-learn 技能创建,各项目的文件由 project-init 技能和后续工作创建。
三种原子类型
实验(EXP-NNN.md)
每个实验是一个记录单次调查的原子文件。实验记录做了什么、观察到了什么、得出了什么结论以及后续应该改变什么。
YAML frontmatter:
---
id: EXP-NNN
date: 2026-01-15
project: my-project
summary: "默认控制器的基线成功率"
tags: [baseline, grasping, evaluation]
status: valid
executor: Cortex
links: [PAT-NNN]
---
必需字段: id、date、project、summary(不超过 300 个字符)、tags。索引生成器会跳过没有
id 的文件;其余字段属于约定,由智能体而非代码检查。
可选字段: status、executor、links(相关条目)。
frontmatter 按 YAML 解析,列表项中含逗号、冒号加空格或花括号时要加引号:evidence: ["log.txt (55 configs, 10 seeds)", "run{1,2}/metrics.json"]。
正文结构: markdown 正文遵循标准模板,包含以下部分:Background、Execution、Results、Conclusion 和 Reflection(目标达成、意外发现、过程缺陷、行为调整)。
状态生命周期: 实验、知识条目和模式共用同一个 status 字段。指向另一个条目的状态在冒号后写出
该条目,例如 superseded:EXP-012;索引生成器按前缀给状态分类。
| 状态 | 含义 | 索引中的表 |
|---|---|---|
active、valid、partial 或空 |
正常,结论成立 | 活跃表 |
challenged:EXP-NNN |
被更新的实验质疑,待复核 | 活跃表,并列入统计 |
corrected:EXP-NNN |
结论已修正 | 活跃表 |
superseded:EXP-NNN |
被更好的版本取代 | 取代/弃用表 |
deprecated |
不再适用 | 取代/弃用表 |
refined:EXP-NNN |
被改进版本完全替代 | 取代/弃用表 |
stale |
长期无人引用,待复核 | 取代/弃用表 |
invalidated:EXP-NNN |
被证明错误,正文替换为墓碑警告 | 无效表 |
其他任何状态都按活跃处理。
知识条目(K-NNN.md)
知识条目是从实验中提炼的原子事实、反模式或启发式。每个条目必须在 evidence 字段中引用其来源实验。
YAML frontmatter:
---
id: K-NNN
date: 2026-02-01
project: my-project
summary: "ANTI-PATTERN: 在随机种子与回合数都不同的多次运行之间比较成功率"
tags: [anti-pattern, evaluation, reproducibility]
evidence: [EXP-NNN, EXP-NNN, EXP-NNN]
---
必需字段: id、date、project、summary、tags、evidence。
反模式约定: 描述反模式的知识条目在摘要前加 ANTI-PATTERN: 并在 tags 中包含 anti-pattern。
模式(PAT-NNN.md)
模式综合了跨多个实验的不变量。模式陈述一个在一组实验中成立的可重用观察。
YAML frontmatter:
---
id: PAT-NNN
date: 2026-02-01
project: my-project
summary: "使用域随机化训练的策略从仿真迁移到真机时,成功率下降更少"
tags: [sim-to-real, domain-randomization, transfer]
source-experiments: [EXP-NNN, EXP-NNN, EXP-NNN]
evidence: [EXP-NNN, EXP-NNN, EXP-NNN]
---
必需字段: id、date、project、summary、tags、source-experiments(从中提取模式的实验)。
正文结构: Observation、Evidence(引用带具体发现的实验表格)、Pattern Statement、Scope & Limitations、Implications。
索引自动生成
项目下的每个目录(experiments/、knowledge/、patterns/)都有一个 index.md,由该目录原子文件的 frontmatter 和项目访问日志生成。索引以 # <Directory> Index — <project> 标题和一行 Use when 开头,随后是警告:
> Auto-generated from YAML frontmatter; Refs / Last ref come from _meta/access-log.jsonl. Do not edit manually. Not tracked by git.
> Last updated: 2026-02-15T09:00:00
生成器只读取原子文件,从不改写它们。项目任一记忆目录里的 .md 文件变动约两秒后,服务端重建该项目的索引(服务运行期间新建的项目会被自动纳入);内置重建作业还会定时重建全部索引。
索引结构:
- 活跃表 — 所有活跃条目(见上方状态表),按引用计数排序(降序),附引用计数和最后访问日期
- 取代/弃用表 — superseded、deprecated、refined 和 stale 条目
- 无效表 — 被证明错误的墓碑化条目
- 统计部分 — 总计数、待复核的 challenged 条目、热门条目(refs >= 5)、冷条目(refs = 0,年龄 > 14 天),以及 frontmatter 不是合法 YAML 的原子文件(仍会逐键读取并入索引,应修正)
重建命令:
--project 可重复使用,未知的项目名会报错。命令以 JSON 输出每个项目及其重建的索引路径。
访问追踪
Cortex 自动追踪研究期间访问了哪些实验、知识和模式文件。这通过 agent:post-tool 上的内置钩子 memory-ref-tracker.mjs 实现(完整钩子系统参见 hooks.md)。
工作原理:
- 每次
Read或Grep工具调用后,钩子检查访问的文件路径是否匹配模式/(experiments|knowledge|patterns)/(EXP-\d+[a-z]?|K-\d+|PAT-\d+)\.md$/ - 如果匹配,它从路径中提取项目名称并追加一行 JSON 到
_meta/access-log.jsonl: - 搜索路径位于项目的
experiments/、knowledge/或patterns/目录内时,Grep才会被追踪。钩子为输出中出现的每个不同原子文件追加一行 - 如果这样的
Grep输出中没有任何原子文件,则记录_directory_search CORTEX_HOME是 git 仓库时,钩子以消息chore: update access log提交访问日志;如果已有其他暂存的改动,则只暂存日志而不提交
引用计数只存在于生成的索引中:每次重建都按访问日志统计每个文件的行数,研究期间频繁读取的文件引用计数更高,在索引中排名更靠前。较早的原子文件可能仍带有 refs:、last-ref: frontmatter 字段,这些字段无人维护,也无人读取。
项目日志文件
每个项目都有一组治理文件,共同构成其运行内存:
mission.md — 宪章
定义项目的目标、成功条件和范围边界。此文件是稳定的,只应在明确的用户批准下更改。它回答:我们试图实现什么,以及我们如何知道已经成功?
roadmap.md — 里程碑地图
分层阶段,每个阶段包含带可测试清单条件的里程碑。已完成的里程碑保留打勾标记(不删除)。路线图显示项目去过哪里、现在在哪里以及要去哪里。
STATUS.md — 当前快照
一个覆盖式(不是仅追加)的状态寄存器,记录项目的现在时——全新 session 正确续作所需的最小状态集。硬上限 80 行且 6KB,单条 bullet 不超过 2 行。必需章节:当前局面、在飞与新变量、阻塞与待决、下一步。凡在别处有持久归宿的事实(实验记录、知识条目、决策记录、commit)只以指针出现;文件大小随状态复杂度变化,绝不随项目时长增长。在局面变化时更新——而非每次任务完成时追加。这是在一段时间后恢复项目工作时首先阅读的文件。
ISSUES.md — 执行摩擦
一个仅追加的日志,记录减慢工作的问题,上限 80 行且 6KB,单条 ≤4 行。条目由带日期的标题、一行现象、一行根因与指向详细调查的指针(知识条目、报告或实验记录)组成。已解决的问题从文件中删除(不归档)。
decisions/ — 决策记录
每个决策是一个文件,命名为 NNNN-title.md,标题为 # DR-NNNN: <Title>。系统级决策放在 context/decisions/,项目决策放在项目的 decisions/,两级各自从 0001 编号。记录先列出 Date、Status(accepted、rejected 或 superseded)、可选的 Supersedes 和 Evidence,再依次是 Context、Options Considered(至少两个方案)、Decision 和 Consequences 各节。
Dense Context 约定
Dense Context 系统遵循以下运行约定:
- 每个目录有 AGENTS.md 索引 — 描述目录的用途、文件列表和查找规则。索引是指针式的(每行一句话+指针,原子目录整目录一行),硬上限 120 行且 8KB,对齐上下文注入预算。随附的
status-md-guard钩子会拒绝让 context 下的AGENTS.md、STATUS.md或ISSUES.md超出上限的Edit或Write;缩小超限文件的写入则允许 - 创建文件 → 更新索引 — 向目录添加新文件时,更新该目录的 AGENTS.md
- 覆盖 vs. 追加 — STATUS.md 覆盖(仅当前状态);ISSUES.md 追加然后删除;experiments/knowledge/patterns 追加并保留
- 来源强制 — 每个事实声明必须追溯到特定的 EXP-NNN、K-NNN、file:line 或内联计算
- 每工作单元后持久化 — 每个逻辑工作单元结束后将上下文更新保存到磁盘。Git 版本历史是可选项
谁负责加载 AGENTS.md
AGENTS.md 正是两个后端本身就会去找的文件名,所以大多数情况下 Cortex 不做任何注入——后端自己就加载了。
| 文件位置 | Claude Code | PI | 由谁加载 |
|---|---|---|---|
| 会话工作目录的祖先目录 | 会 | 会 | 后端 |
| 工作目录的子目录,且读取了其中的文件时 | 会 | 不会 | Claude 上由后端加载,PI 上由 agents-md-injector 钩子加载 |
| 工作目录树之外 | 不会 | 不会 | agents-md-injector 钩子 |
任意位置的 AGENTS.local.md |
不会 | 不会 | agents-md-injector 钩子 |
远程设备上,经 remote_read / remote_write / remote_edit |
不会 | 不会 | cortex-client 扫描器,作为附加的工具结果块注入 |
会话默认运行在 Cortex 主目录下,因此 ~/.cortex/AGENTS.md 以及 context/ 下的每个索引要么是工作目录的祖先、要么是其子目录,都会被后端原生加载。钩子只负责剩下的那几行,并把后端已加载的文件记入一份按会话共享的缓存,确保同一份规则不会被送两遍。
有两点值得注意:
- 祖先链上只要出现任何一个
CLAUDE.md,Claude 的AGENTS.md回退机制就会被整体关闭——这由claude-md-or-agents-md设置控制,是全有或全无,而不是按目录合并。钩子会检测到这种情况并恢复注入以免丢规则,但仍应避免在同一棵目录树里混用两种文件名。 - 两个后端都不读
.local变体。AGENTS.local.md是 Cortex 自己的约定,用于机器相关的规则,由钩子投递并且不纳入 git。
在工作台中浏览记忆
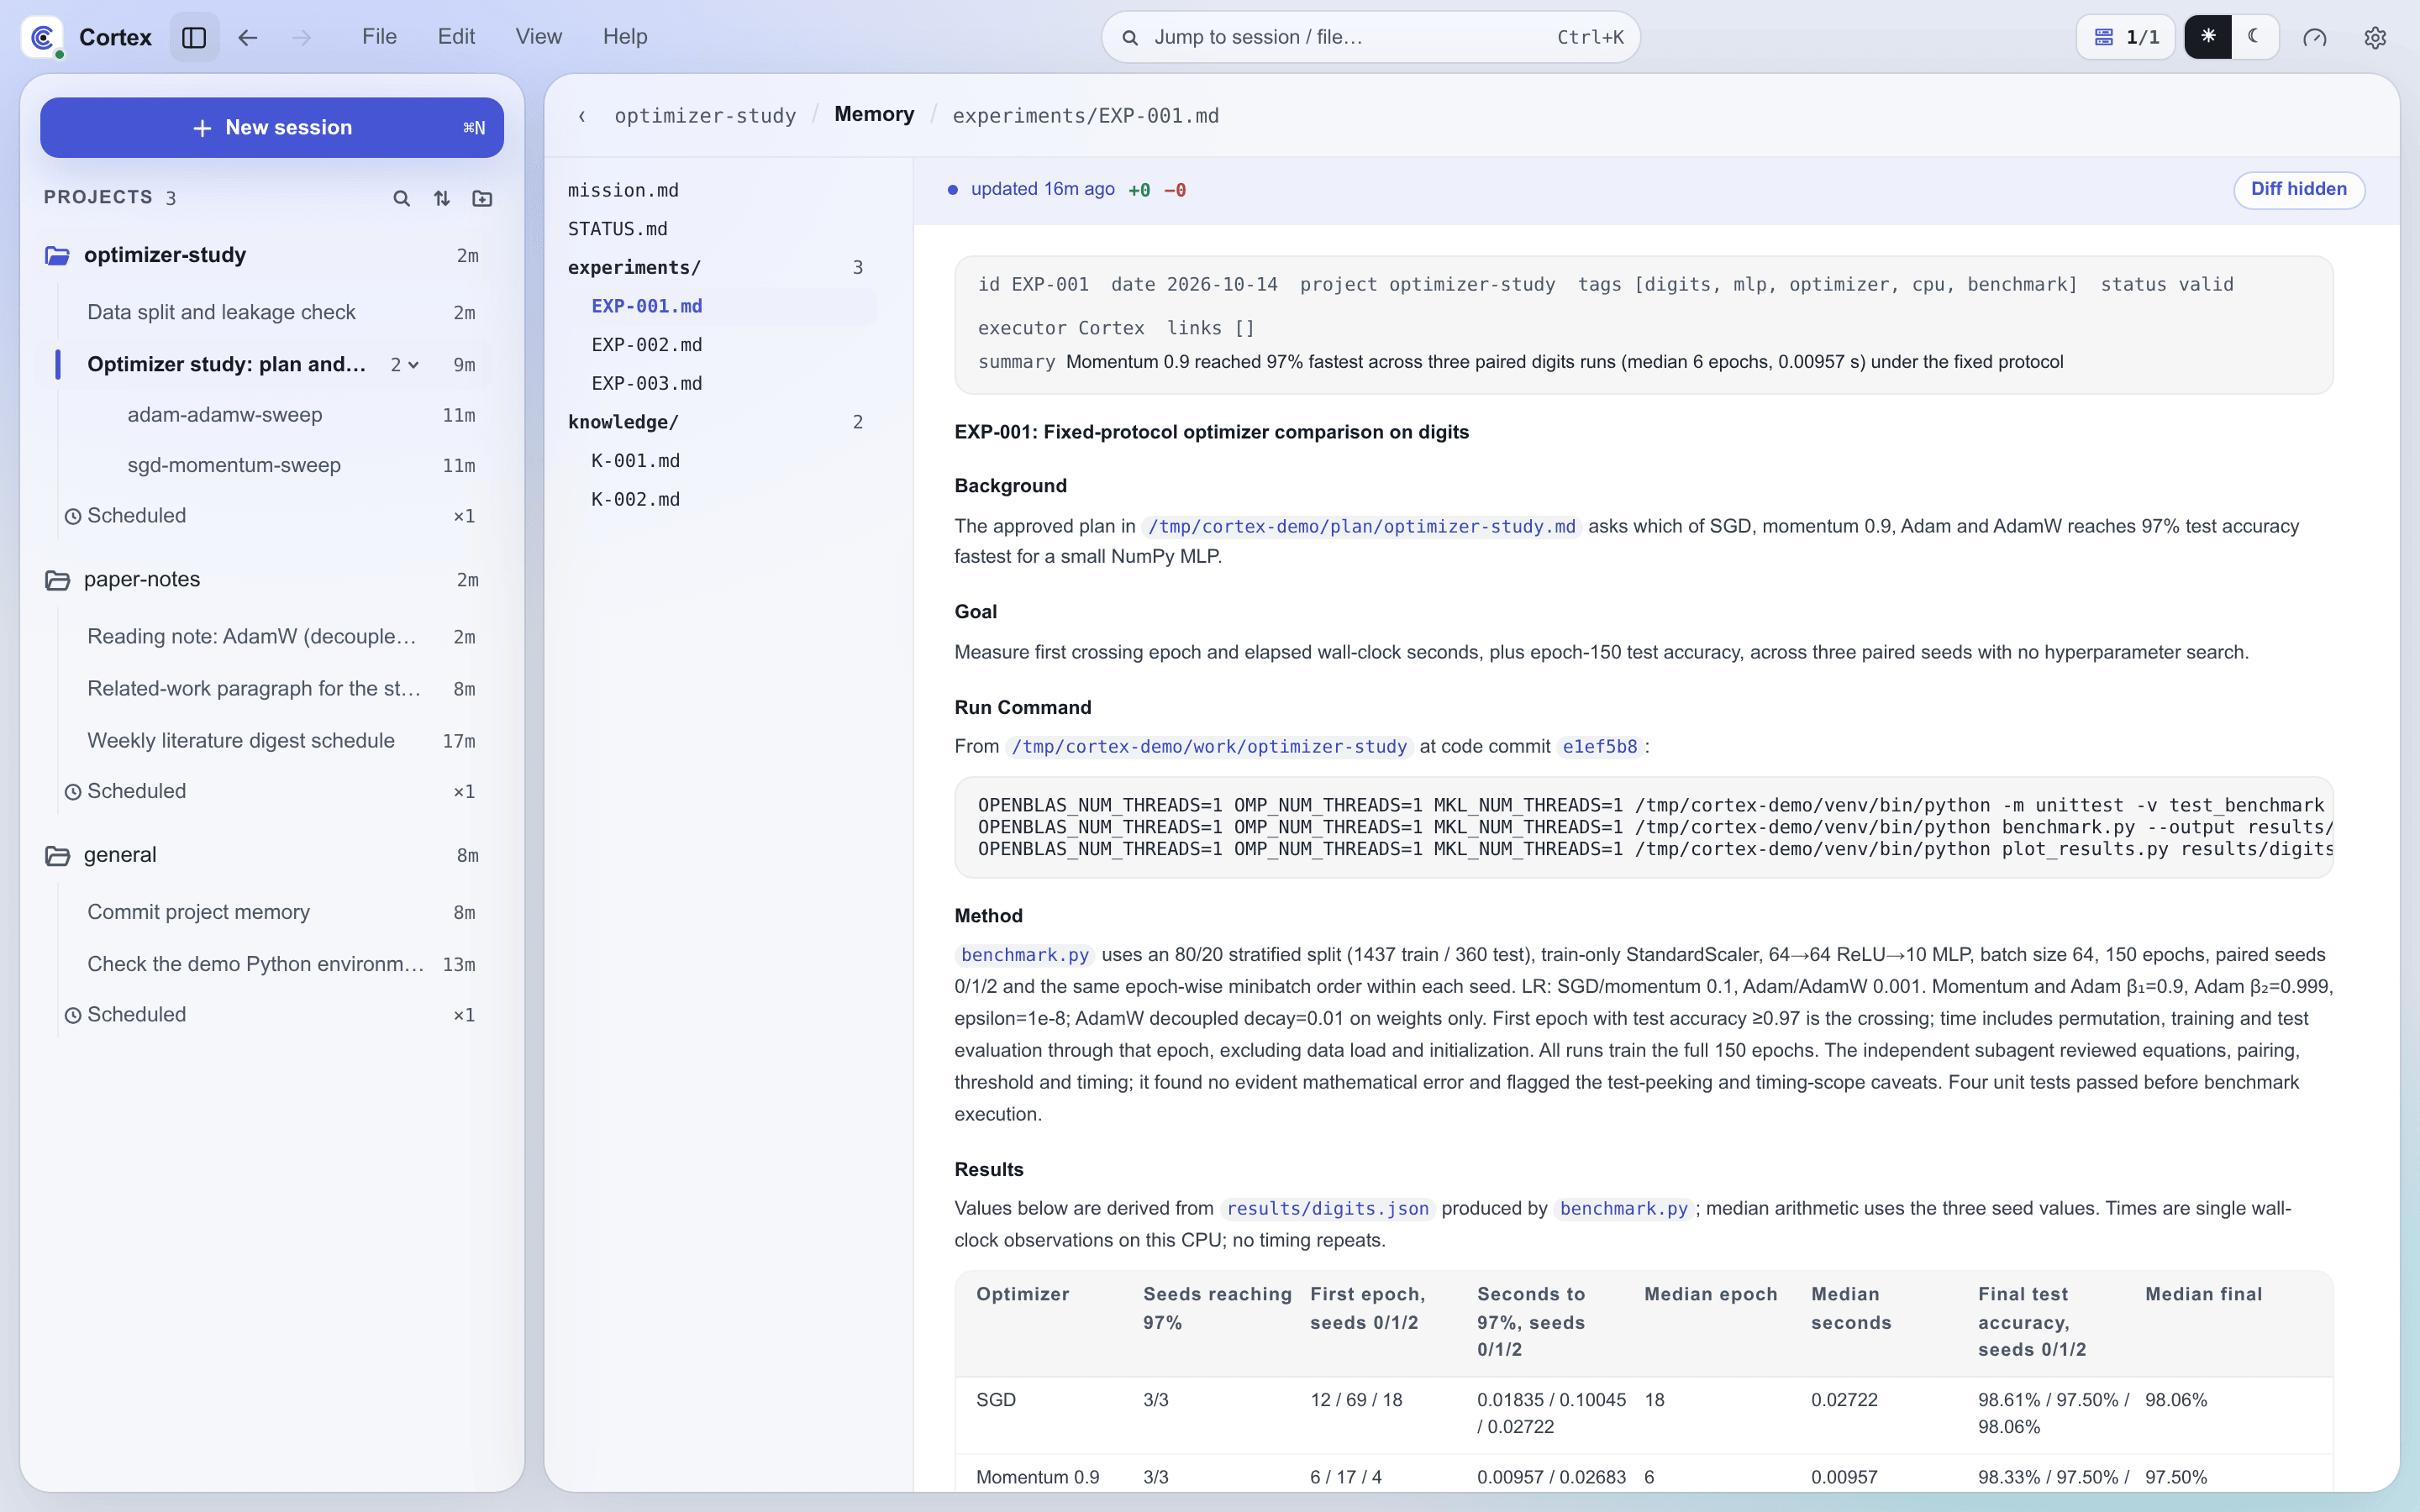
Web 工作台以只读方式展示项目记忆。桌面端可通过视图 → 记忆或项目 Overview 上的打开记忆查看器进入;
手机端则是项目面板中的项目记忆。它列出 mission.md、roadmap.md、STATUS.md,以及
experiments/、knowledge/、patterns/ 和 decisions/ 中的文件(不含自动生成的 index.md),渲染所选
文件;项目位于 git 工作树中时,还显示与 HEAD 相比改动了多少行,以及每一行最近一次的修改。
全新会话测试
Dense Context 质量的酸性测试:如果你启动一个仅对仓库有读取权限的全新会话,你能学到上一个会话知道的所有信息吗?如果答案是否定的,说明有内容未被正确记录。
内存索引重建作业
内置记忆索引重建任务会从 YAML frontmatter 重建所有索引文件,由 config/settings.json 中的 memoryIndexRegenEnabled(默认 true)和 memoryIndexRegenIntervalMs(默认 24 小时)控制。该任务会:
- 扫描
context/projects/下的所有项目 - 从每个
EXP-*.md、K-*.md和PAT-*.md读取 frontmatter - 从
_meta/access-log.jsonl统计每个文件的引用次数 - 原子地写入各
index.md,原子文件保持不变
生命周期:知识维护
cortex memory consolidate 检查每个项目的实验、知识条目和模式,报告需要处理的地方。它默认输出 JSON,加 --text 输出可读摘要,不修改任何文件。它报告:
- 合并候选 — 共享标签或彼此链接紧密、适合合并的实验,以及连续取代形成的链
- 矛盾 — 证据实验已被标为 invalidated、superseded 或 deprecated 的知识条目和模式,按证据全部失效或部分失效标注
- 陈旧候选 — 超过 30 天、访问日志中没有任何引用的活跃条目
- 反模式信号 — 在多个实验的反思中反复出现的过程缺陷
规模
索引重建随项目增长依然廉价。一次重建只解析每个文件的 YAML frontmatter,因此一次性为所有项目重建索引——每个项目有几十个实验以及若干知识条目和模式——不到一秒即可完成。